
Staat een pagina niet in Google, dan zit de oorzaak bijna altijd in een van vier dingen. Je blokkeert de pagina zelf (noindex of robots.txt). Google kiest een andere URL als hoofdversie (canonical). Google vindt de pagina slecht (te weinig interne links, rommelige sitemap). Of Google vindt de pagina het opnemen niet waard (dunne of dubbele inhoud). Begin dus niet met op “Indexering aanvragen” klikken. Begin met de URL-inspectie in Search Console. Die laat je in 30 seconden zien welke van de vier het is, en pas dan weet je wat je moet doen.
Kort samengevat
- Crawlen, indexeren en ranken zijn drie aparte stappen. Google kan een pagina bezocht hebben die toch niet in de index staat.
- Controleer met de URL-inspectietool en het rapport Pagina-indexering. Een site:-zoekopdracht geeft alleen een ruwe schatting.
- ‘Gevonden’ en ‘Gecrawld – momenteel niet geïndexeerd’ lijken op elkaar, maar vragen elk een andere oplossing.
- Een indexeringsverzoek is geen garantie en lost geen oorzaak op.
- Zijn honderden URL’s uitgesloten? Dan zit het probleem in de opbouw van je site, niet in losse pagina’s.
Inhoudsopgave
- Crawlen, indexeren, ranken: drie stappen, drie soorten problemen
- Zo stel je vast of je echt een indexatieprobleem hebt
- De meldingen in Search Console, vertaald naar actie
- De oorzaken die we het vaakst tegenkomen
- Oplossen in de juiste volgorde
- Indexering aanvragen: wat het wel en niet doet
- Hoe lang duurt indexeren?
- Voorkomen dat pagina’s uit de index verdwijnen
- Onze kijk: indexatie is een keuze van Google, geen recht
- Hulp bij hardnekkige indexatieproblemen
- Veelgestelde vragen
- Bronnen
Crawlen, indexeren, ranken: drie stappen, drie soorten problemen
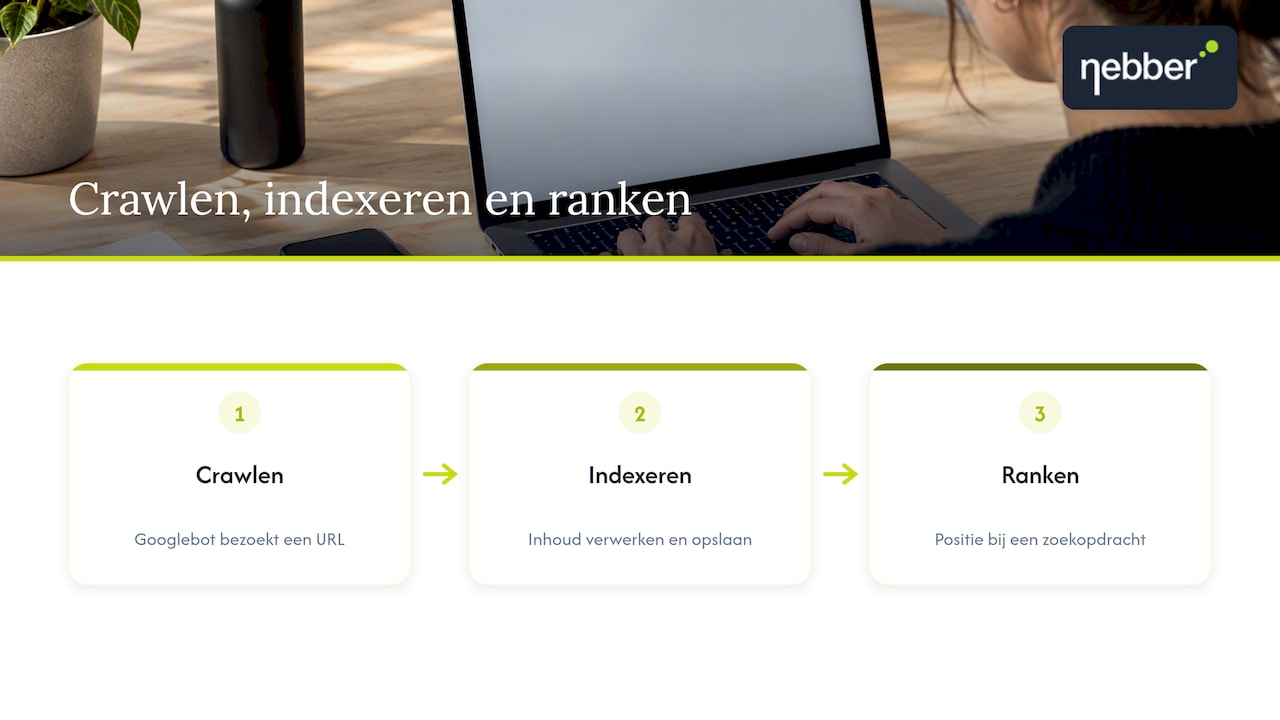
Crawlen betekent dat Googlebot een URL bezoekt. Indexeren betekent dat Google de inhoud van die pagina verwerkt en opslaat in de Google-index. Pas daarna kan de pagina in de zoekresultaten verschijnen. Ranken is de laatste stap: op welke positie de pagina komt voor een zoekopdracht.
Bij indexeren doet Google meer dan opslaan. Het systeem groepeert pagina’s met vergelijkbare inhoud en kiest per groep één canonieke versie die in de resultaten komt. Dat staat in Googles uitleg over hoe Zoeken werkt. Hebben vijf URL’s dus bijna dezelfde inhoud, dan haalt meestal maar één de index. De andere vier bestaan voor Google wel, maar tellen niet mee.
Zie het als een archief. Crawlen is de postbode die de brief brengt. Indexeren is de archivaris die de brief leest en in de juiste kast legt, of in de papierbak gooit. Ranken is de vraag of iemand die brief ooit uit de kast pakt. Ligt de brief niet in de kast, dan pakt niemand hem.
Dat maakt een indexatieprobleem zo hard. Een pagina op positie 15 krijgt nog een paar vertoningen. Een pagina die niet in de index staat krijgt er 0, hoe goed de tekst ook is. Bij een nieuwe website is dit vaak het eerste probleem dat je tegenkomt, omdat Google je domein nog niet kent. Wat je in de eerste weken doet voor de indexering van een nieuwe site bepaalt hoe snel je daar doorheen bent.
Zo stel je vast of je echt een indexatieprobleem hebt
Niet elke pagina die je niet terugziet, ontbreekt in de index. Soms staat hij er gewoon in en rankt hij alleen slecht. Dat is een ander probleem met een andere oplossing. Werk daarom in deze volgorde:
- Snelle check met site:. Zoek in Google op
site:jouwdomein.nlof op een specifieke URL. Google noemt deze syntaxis zelf als manier om te controleren of je site in de index staat. Het aantal resultaten is wel een schatting. Gebruik het als thermometer, niet als weegschaal. - URL-inspectie per pagina. Plak de URL in de inspectietool van Search Console. Je ziet of de URL op Google staat, wanneer Google voor het laatst crawlde, welke canonical jij opgeeft en welke Google kiest. Wijken die twee af, dan heb je je eerste spoor.
- Rapport Pagina-indexering. Hier zie je per reden hoeveel URL’s niet geïndexeerd zijn. Dit is je overzicht van de hele site.
- Controleer je property. Gebruik bij voorkeur een domeinproperty, zodat www, non-www, http en https allemaal meetellen. Anders kijk je naar de helft van je site en mis je de rest.
Eén ontbrekende URL is een incident. Duizend ontbrekende URL’s is een patroon. Bij een patroon zoek je de oorzaak in templates, filters of instellingen, nooit pagina voor pagina.
De meldingen in Search Console, vertaald naar actie
In het rapport Pagina-indexering geeft Google per uitgesloten URL een reden. De helppagina bij het rapport legt ze allemaal uit. Dit zijn de meldingen die je het vaakst ziet, met de eerste stap die je zet.
| Melding | Wat er aan de hand is | Eerste actie |
|---|---|---|
| Uitgesloten door noindex-tag | De pagina vraagt Google zelf om haar niet op te nemen | Moet de pagina in Google? Haal de noindex weg |
| Geblokkeerd door robots.txt | Google mag de pagina niet crawlen | Pas de Disallow-regel aan als de pagina belangrijk is |
| Gevonden – momenteel niet geïndexeerd | Google kent de URL, maar heeft hem nog niet gecrawld | Kijk naar interne links, serversnelheid en het totale aantal URL’s |
| Gecrawld – momenteel niet geïndexeerd | Google heeft de pagina bekeken en (nog) niet opgenomen | Beoordeel inhoud, unieke waarde en duplicatie |
| Duplicaat, Google heeft een andere canonieke pagina gekozen dan de gebruiker | Jouw canonical en Googles keuze verschillen | Maak signalen gelijk: canonical, interne links en sitemap |
| Duplicaat zonder door gebruiker geselecteerde canonieke versie | Er is geen canonical en Google ziet dubbele inhoud | Stel een canonical in of voeg pagina’s samen |
| Alternatieve pagina met correcte canonieke tag | De pagina verwijst netjes naar een hoofdversie | Meestal niets: dit is vaak precies wat je wilt |
| Pagina met omleiding | De URL stuurt door naar een andere | Niets, tenzij er interne links of sitemap-items naar wijzen |
| Soft 404 | De pagina geeft code 200, maar lijkt leeg of een foutpagina | Vul de pagina met inhoud of geef een echte 404 of 410 |
| Serverfout (5xx) | De server gaf een fout toen Google langskwam | Laat je hosting of developer de logs nakijken |
Let op de twee rijen met “meestal niets”. Een groot getal bij ‘Pagina met omleiding’ na een migratie is normaal. Ga dat niet repareren. Je stopt dan uren in een probleem dat er niet is, terwijl het echte lek ergens anders zit.
De oorzaken die we het vaakst tegenkomen
Google noemt zelf blokkering door robots.txt, een noindex-instructie, andere technische problemen en slechte vindbaarheid als veelvoorkomende redenen. In de praktijk vallen ze uiteen in zes groepen.
Een vergeten noindex
De klassieker. Een testomgeving staat op noindex, en bij livegang gaat die instelling mee. In WordPress is het één vinkje bij “Zoekmachines ontmoedigen deze site te indexeren”. Een noindex kan ook in de HTTP-header zitten (X-Robots-Tag), en dan zie je hem niet in de broncode. Controleer dus allebei.
Eén vinkje, hele site weg.
Robots.txt blokkeert te veel
Een Disallow: / uit de testomgeving, of een regel die bedoeld was voor filters maar ook je productpagina’s raakt. Robots.txt bepaalt wat Google mag crawlen, niet wat in de index komt. Dat leidt tot een verraderlijke combinatie: zet je een noindex op een pagina die je ook blokkeert in robots.txt, dan kan Google die noindex nooit lezen. Het hek staat dicht, dus niemand ziet het bordje erachter. Hoe je dit goed inricht, lees je in ons stuk over robots.txt en SEO.
Een canonical die de verkeerde kant op wijst
Een canonical is een verhuisbericht: “de echte versie woont daar”. Staat dat bericht verkeerd, dan gaat al je post naar het verkeerde adres. Typische fouten: een template dat op alle pagina’s de homepage als canonical zet, paginering die naar pagina 1 verwijst, of een canonical naar de http-versie terwijl je site op https draait.
Google ziet een canonical als hint, niet als bevel. Wijzen je interne links en je sitemap naar URL A en je canonical naar URL B, dan kiest Google zelf. Maak alle signalen gelijk. Dan heb je de beslissing weer in eigen hand.
Dunne of dubbele inhoud
Google noemt lage inhoudskwaliteit als mogelijke reden dat een pagina niet wordt geïndexeerd. Je herkent het aan ‘Gecrawld – momenteel niet geïndexeerd’ op grote aantallen vergelijkbare pagina’s.
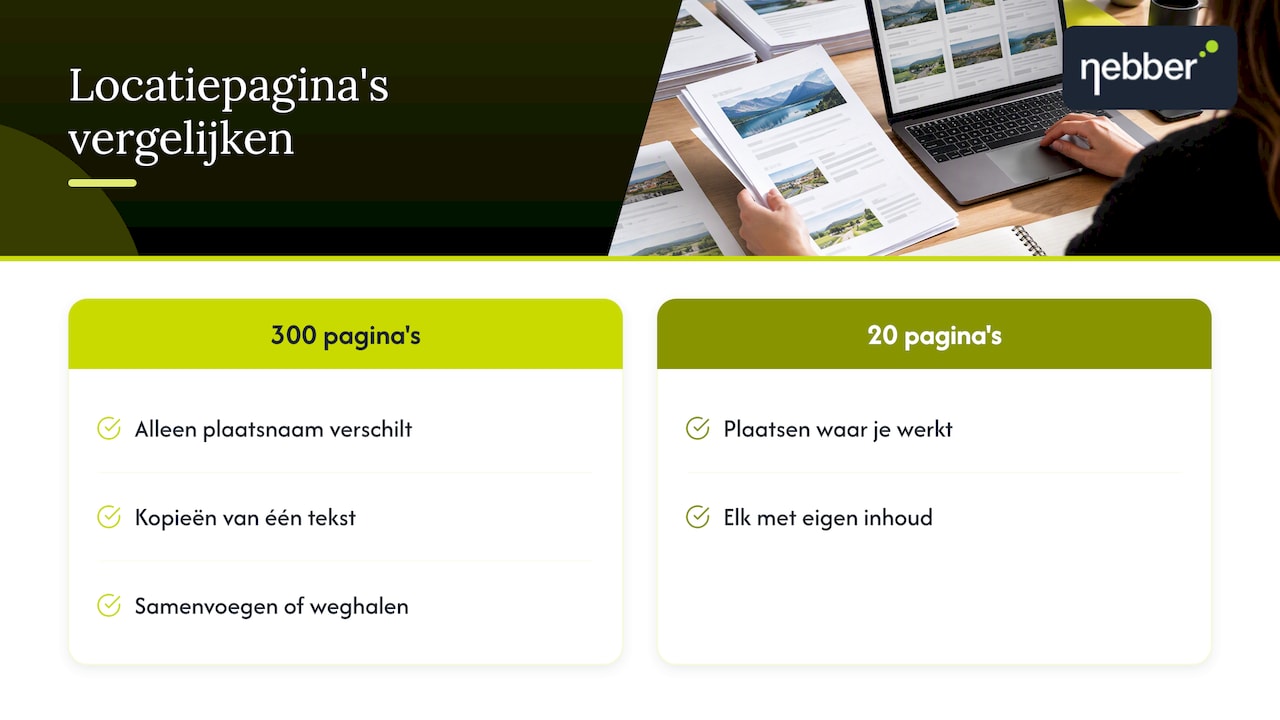
Een voorbeeld. Een dienstverlener maakt 300 locatiepagina’s waarop alleen de plaatsnaam verschilt. Dat zijn voor Google 300 kopieën van één tekst. Stuur je 300 soldaten met hetzelfde wapen naar dezelfde heuvel, dan haalt er hoogstens één de top. Beter: 20 pagina’s voor de plaatsen waar je echt werkt, elk met eigen inhoud, en de rest samenvoegen of weghalen.
Soms is dit ook niet op te lossen met tekst. Is een pagina terecht dun, zoals een filtercombinatie zonder zoekvraag, dan hoort hij niet in de index. Zet hem dan bewust op noindex.
Pagina’s die niemand aanwijst
Een pagina zonder interne links is een kamer zonder deur. Google kan hem via de sitemap vinden, maar krijgt geen enkel signaal dat hij belangrijk is. Dit zie je vaak bij ‘Gevonden – momenteel niet geïndexeerd’. Een sitemap helpt bij het ontdekken, maar vervangt geen interne links. Wat een sitemap wel en niet doet, staat in ons artikel over de XML-sitemap en SEO. Ook een logische URL-structuur maakt het voor Google makkelijker om je site in kaart te brengen.
Technische fouten en JavaScript
Serverfouten, een trage server, redirectketens van 3 of 4 stappen, en inhoud die pas na JavaScript verschijnt. Bij dat laatste ziet Google bij de eerste ronde soms een lege pagina. Test in de URL-inspectie met “Live URL testen” en bekijk de gerenderde HTML. Staat je hoofdtekst daar niet in, dan weet je genoeg.
Schone, semantische HTML helpt crawlers en schermlezers tegelijk. Een plan voor SEO en toegankelijkheid laat zien welke fixes je dubbel opleveren.
Oplossen in de juiste volgorde
De volgorde is belangrijker dan de snelheid. Je zet geen nieuwe emmers neer zolang het dak nog lekt.
- Blokkades eerst. Haal onterechte noindex-tags en robots.txt-regels weg. Dit is de enige stap die in één release een hele site terug kan brengen.
- Technische fouten. Los 5xx-fouten, soft 404’s en redirectketens op. Laat interne links direct naar de eindbestemming wijzen.
- Canonicals en duplicaten. Maak canonical, interne links en sitemap eensgezind. Voeg pagina’s die hetzelfde doen samen met een 301.
- Vindbaarheid. Link belangrijke pagina’s vanuit je menu, categorieën en gerelateerde artikelen. Zet alleen indexeerbare URL’s met code 200 in je sitemap.
- Kwaliteit. Verbeter of schrap pagina’s die ‘Gecrawld – momenteel niet geïndexeerd’ krijgen. Schrappen is vaak de betere keuze.
- Valideren. Klik in het rapport Pagina-indexering op “Oplossing valideren” en vraag voor een handvol sleutelpagina’s indexering aan.
Stap 1 tot en met 3 liggen meestal bij je developer. Een fix die op de backlog blijft liggen, lost niets op. Hoe je dat soepel laat lopen, lees je in SEO en developers laten samenwerken.
Indexering aanvragen: wat het wel en niet doet
In de URL-inspectietool staat de knop “Indexering aanvragen”. Google legt uit dat je hiermee een URL opnieuw kunt laten crawlen, maar dat het geen garantie geeft dat de pagina wordt opgenomen.
Gebruik de knop voor 5 tot 10 belangrijke pagina’s nadat je een oorzaak hebt opgelost. Niet voor 400 productpagina’s, en niet als eerste reactie op een probleem. Als de oorzaak blijft, komt de pagina terug in hetzelfde rapport. Je drukt dan op de deurbel terwijl het bordje “niet storen” nog op de deur hangt.
Voor grote aantallen werken een schone sitemap en sterke interne links beter. Die doen het werk ook als jij niet kijkt.
Hoe lang duurt indexeren?
Volgens Google kan het van 1 of 2 dagen tot een aantal weken duren. Het hangt af van hoe vaak Google je site bezoekt, hoe snel je server reageert, hoe goed de pagina is gelinkt en hoeveel URL’s je site heeft.
Onze vuistregel: staat een technisch schone, goed gelinkte pagina na 4 weken nog steeds niet in de index, dan is wachten geen strategie meer. Dan zegt Google iets over de waarde van die pagina, en dat signaal moet je serieus nemen.
Bij sites met tienduizenden URL’s speelt ook het crawlbudget mee. Google besteedt dan tijd aan filters en parameters in plaats van aan je belangrijke pagina’s. Wanneer dat echt telt, lees je in crawlbudget optimaliseren. Voor een site van 200 pagina’s is het zelden het probleem.
Voorkomen dat pagina’s uit de index verdwijnen
Bestaande pagina’s die verdwijnen, kosten meer dan nieuwe pagina’s die niet binnenkomen. Die hadden al verkeer. Google adviseert om te controleren dat pagina’s niet onbedoeld worden geblokkeerd en om Google te helpen ze te vinden en te crawlen. In de praktijk betekent dat:
- Een releasecheck. Controleer na elke livegang robots.txt, meta robots en canonicals op 5 vaste pagina’s: homepage, een categorie, een product of dienst, een artikel en een contactpagina.
- Wekelijks het rapport bekijken. Let niet op het totaal, maar op sprongen. Stijgt ‘Uitgesloten door noindex-tag’ in één week met 30%, dan is er iets veranderd.
- Migraties plannen. Elke oude URL krijgt een 301 naar de nieuwe, en interne links gaan direct naar de nieuwe URL.
- Interne links bewaken. Haal je een categorie uit het menu, controleer dan of de pagina’s eronder nog bereikbaar zijn.
- Een schone sitemap. Alleen URL’s met code 200, zonder noindex en met een canonical naar zichzelf.
Voor developers die dit structureel willen borgen, staat alles op één plek in onze technische SEO-checklist voor developers.
Onze kijk: indexatie is een keuze van Google, geen recht
Na 19 jaar in SEO zien we steeds hetzelfde patroon. Een bedrijf ziet dat pagina’s niet in Google staan en gaat op knoppen drukken. Indexering aanvragen, sitemap opnieuw indienen, nog een keer aanvragen. Dat voelt als actie. Het is wachten met extra stappen.
Indexatieproblemen zijn bijna altijd een symptoom. De oorzaak zit in een template, een instelling of in de keuze om pagina’s te maken die geen eigen waarde hebben. Die los je niet op in Search Console, maar in de code, de structuur en de inhoud. Daarom werken we direct samen met de developers, copywriters en andere webprofessionals die de wijziging ook echt doorvoeren. Een advies in een rapport dat niemand uitvoert, haalt geen enkele pagina terug in de index.
We zeggen ook eerlijk wanneer je ons niet nodig hebt. Heb je een site van 30 pagina’s en staat er één niet in? Loop dan de stappen in dit artikel zelf door. Grote kans dat je de oorzaak binnen een uur vindt. Gaat het om honderden of duizenden URL’s, of om pagina’s die omzet opleveren, dan wordt het anders. Dan wil je een rapportage die het management begrijpt: welke fix, hoeveel pagina’s, en wat het naar verwachting oplevert. Zo krijg je de developertijd die nodig is.
Google hoeft niets op te nemen. Jij moet laten zien waarom het wel zou moeten.
— Ramon
Hulp bij hardnekkige indexatieproblemen
Blijven pagina’s uit de index terwijl je de basis op orde hebt? Met een technische scan brengen we snel in kaart waar het lekt. Wil je de hele site doorgelicht hebben, inclusief canonicals, interne links, rendering en een concrete lijst met fixes op volgorde van impact, dan is een technische audit de logische stap.
We leveren geen dik rapport dat in een la verdwijnt. We zorgen samen met je developer dat de wijzigingen live gaan, en meten daarna of de pagina’s terugkomen. Wil je eerst weten wat je kunt verwachten? Lees dan wat een SEO-audit kost of neem contact op via nebber.nl.
Veelgestelde vragen
Wat betekent indexatie in Google?
Indexatie is de stap waarin Google een gecrawlde pagina verwerkt en opslaat in de index. Alleen pagina’s in die index kunnen in de zoekresultaten verschijnen. Crawlen komt ervoor, ranken komt erna.
Wat betekent niet-indexerend?
Een niet-indexerende pagina vraagt Google om haar niet op te nemen, meestal met een noindex-tag in de HTML of een X-Robots-Tag in de HTTP-header. Dat is handig voor bedankpagina’s, interne zoekresultaten of filtercombinaties. Staat de tag per ongeluk op een belangrijke pagina, dan verdwijnt die pagina uit Google.
Hoe lang duurt het voordat Google een pagina indexeert?
Google noemt een periode van 1 of 2 dagen tot een aantal weken. Snelheid hangt af van hoe vaak Google je site bezoekt, je serversnelheid en je interne links. Staat een schone, goed gelinkte pagina er na 4 weken nog niet in, zoek dan naar een oorzaak in plaats van te wachten.
Moet ik elke uitgesloten URL in Search Console oplossen?
Nee. Meldingen als ‘Pagina met omleiding’ en ‘Alternatieve pagina met correcte canonieke tag’ laten vaak zien dat je site precies doet wat de bedoeling is. Richt je op uitgesloten URL’s die wél in Google horen te staan, zoals product-, dienst- en categoriepagina’s.
Bronnen
- Het rapport Pagina-indexering – Help voor Search Console
- Waarom ontbreekt mijn pagina op Google Zoeken? – Help voor Search Console
- Leitfaden zur Funktionsweise der Google Suche – Google for Developers