
Robots.txt stuurt wie je site mag bezoeken, het regelt crawling, niet indexering. Dat onderscheid is de kern van bijna elke fout die we tegenkomen. Gebruik het bestand om crawl-budget te sturen, niet om pagina’s te verwijderen uit Google. Zet je per ongeluk een regel die CSS of JavaScript blokkeert, dan breekt de rendering en kan je ranking in een paar dagen wegzakken.
Kort samengevat:
- Alleen het gebruik van robots.txt om crawl-budget te sturen is effectief; het blokkeert niet automatisch pagina’s uit zoekresultaten.
- Het blokkeren van CSS en JavaScript in robots.txt kan de rendering verstoren, wat snelle rankingdalingen tot gevolg kan hebben.
- Bij sitewijzigingen moet je altijd controleren of je geen onbedoelde disallow- of hoofdletter-fouten hebt gemaakt, omdat deze de indexering kunnen blokkeren.
- Gebruik altijd een actuele sitemap en voorkom te grote robots.txt-bestanden, omdat deze anders niet correct worden gelezen door crawlers.
- Een disallow-regel blokkeert niet automatisch de pagina in Google; gebruik in plaats daarvan altijd de noindex-metatag om pagina’s te verwijderen uit zoekresultaten.
Inhoudsopgave
- Wat is robots.txt en waarom bestaat het
- Syntax en regels: user-agent, allow, disallow, sitemap en wildcards
- Robots.txt en crawlbudget: wanneer blokkeer je wel en niet
- Gevaarlijke fouten en hoe je ze herstelt
- Hoe je robots.txt test en valideert voor je live gaat
- Implementatie: uploaden, hosting en CMS-specifieke aandachtspunten
- Gevorderde scenario’s: grote sites, dynamische robots.txt en staging
- Praktijkchecklist: wat we in audits het vaakst terugzien
- Waarom ik robots.txt altijd als verkeersregelaar zie
- Hulp nodig bij je robots.txt en technische SEO
- Veelgestelde vragen
- Bronnen
Wat is robots.txt en waarom bestaat het
Robots.txt is een tekstbestand dat altijd op dezelfde plek staat: jouwdomein.nl/robots.txt. Het is het eerste wat een crawler leest voordat hij je site bezoekt, net zoals een bezoeker eerst het bordje bij de ingang leest voordat hij naar binnen loopt. Staat er “verboden toegang” op een deur, dan betekent dat niet dat de ruimte erachter niet bestaat. Het betekent alleen dat niemand er via die deur in mag.
Dat is precies de denkfout die het vaakst misgaat. Crawling is het bezoek: de bot komt langs, leest de pagina, volgt links. Indexering is de beslissing om die pagina op te slaan en te laten zien in zoekresultaten. Robots.txt regelt alleen het bezoek. Blokkeer je een pagina met disallow, dan kan Google haar URL toch nog tonen in de zoekresultaten als er elders genoeg linksignalen naar verwijzen, maar dan zonder titel of beschrijving. Dat verwart veel mensen: ze denken dat disallow gelijk staat aan verwijderen, en dat klopt niet, zoals Search Engine Land uitlegt.
Sitemaps werken juist aanvullend. Waar robots.txt de deuren dichtgooit die je niet wilt laten bezoeken, wijst je sitemap de crawler actief naar de pagina’s die je wél wilt laten zien. Samen vormen ze een trechter: robots.txt houdt ruis buiten de deur, de sitemap duwt de belangrijke content naar voren.
De drie bouwstenen die je altijd nodig hebt:
- User-agent: voor welke bot de regels gelden (Googlebot, Bingbot, of een sterretje voor iedereen).
- Allow/Disallow: welke paden wel of niet bezocht mogen worden.
- Sitemap: een directe verwijzing naar je XML-sitemap, zodat crawlers die sneller vinden.
Syntax en regels: user-agent, allow, disallow, sitemap en wildcards
De opbouw van robots.txt is simpel, maar de details bepalen of het werkt zoals je bedoelt. Elke groep begint met een User-agent regel, gevolgd door een of meer Allow of Disallow regels die voor die specifieke bot gelden. Een lege regel of een nieuwe User-agent start een nieuwe groep.
Een voorbeeld van een typische structuur:
User-agent: *
Disallow: /winkelwagen/
Disallow: /zoeken?
Allow: /zoeken/categorie/

Sitemap: https://jouwdomein.nl/sitemap.xml
Wat hier vaak mis begrepen wordt, is hoe Google kiest tussen een Allow en een Disallow die elkaar lijken tegen te spreken. De regel is simpel: de langste match wint. Een Disallow: /zoeken? sluit algemene zoekresultaten uit, maar Allow: /zoeken/categorie/ is specifieker en wint dus van de bredere disallow, ook al staat hij erna. Dit “longest match” principe staat beschreven in de officiële specificatie van Google en is vastgelegd in RFC 9309, het protocol dat robots.txt internationaal standaardiseert.
Wildcards maken regels krachtiger, maar ook gevaarlijker als je ze niet goed begrijpt:
| Teken | Betekenis | Voorbeeld |
|---|---|---|
* |
Vervangt elke reeks tekens | /producten/*/review blokkeert elk reviewpad onder producten |
$ |
Markeert het einde van de URL | /*.pdf$ blokkeert alleen bestanden die exact op .pdf eindigen |
/pad/ |
Blokkeert alles onder dat pad inclusief subpaden | /admin/ blokkeert ook /admin/instellingen/ |
/pad zonder slash |
Blokkeert ook URL’s die met dat woord beginnen | /win blokkeert ook /winkelwagen/ |
Dat laatste punt, de trailing slash, is een klassieke valkuil. Vergeet je de slash, dan vang je soms veel meer paden dan je wilde, als een net met te grote mazen dat ineens de verkeerde vis meetrekt.
Robots.txt is ook hoofdlettergevoelig. /Producten/ en /producten/ zijn voor de parser twee totaal verschillende paden. Typ je de regel met een hoofdletter terwijl je URL’s kleine letters gebruiken, dan blokkeer je helemaal niets, en dat ontdek je meestal te laat.
Een paar technische randvoorwaarden die vaak over het hoofd gezien worden:
- Het bestand moet UTF-8 gecodeerd zijn, anders kunnen crawlers regels verkeerd interpreteren.
- Er mag maar één robots.txt per combinatie van protocol, host en poort bestaan, zo staat te lezen in de implementatiegids van Google.
- Een bestand groter dan 500 KiB kan door crawlers deels genegeerd worden, iets waar grote sites rekening mee moeten houden.
Robots.txt en crawlbudget: wanneer blokkeer je wel en niet
Crawl-budget is niet onbeperkt. Elke crawler verdeelt zijn bezoektijd over je site, en die tijd gaat naar de pagina’s die het makkelijkst te bereiken zijn, niet automatisch naar de belangrijkste. Vul je je site met duizenden URL’s vol filterparameters en interne zoekresultaten, dan gaat een flink deel van dat budget naar ruis terwijl je nieuwe productpagina’s wachten op hun beurt.
Denk aan crawl-budget als het water dat door een leiding stroomt. Heb je lekken bij elke bocht (parameters, dubbele content, eindeloze interne zoekpagina’s), dan komt er minder druk aan bij de kraan waar het echt om gaat: je belangrijkste content.
Welke URL-typen zijn kandidaten om te blokkeren:
- Interne zoekresultaten en filterparameters die duizenden near-duplicate URL’s genereren.
- Winkelwagen-, checkout- en accountpagina’s die niets toevoegen aan de zoekresultaten.
- Gepagineerde of gesorteerde variaties van dezelfde productlijst (
?sort=prijs,?pagina=12). - Interne trackingparameters die dezelfde pagina onder tientallen URL-varianten laten zien.
De vuistregel is simpel: blokkeer vervuiling, nooit de bouwstenen van je pagina. CSS- en JavaScript-bestanden horen daar nooit bij, ook niet als ze in een map staan die verder weinig met content te maken heeft. Googlebot moet die bestanden kunnen laden om te zien hoe je pagina daadwerkelijk rendert, en een gerenderde pagina is precies wat Google beoordeelt.
Combineer robots.txt altijd met canonical tags en een opgeschoonde sitemap. Robots.txt stopt het bezoek, canonical tags leggen uit welke versie telt als er toch meerdere varianten bestaan, en de sitemap duwt de crawler richting wat echt telt. Zonder die combinatie dweil je met de kraan open: je blokkeert één lek, maar de rest van het systeem blijft water verliezen.
Pro-tip: check in je serverlogs welke URL-patronen het meeste crawlverkeer trekken voordat je iets blokkeert, dan blokkeer je op bewijs in plaats van een vermoeden.
Meer over hoe je die verspilling concreet opspoort, lees je in onze uitleg over logfile-analyse voor SEO.
Gevaarlijke fouten en hoe je ze herstelt
De meeste schade aan rankings door robots.txt komt niet van complexe scenario’s, maar van een paar terugkerende fouten.
- CSS en JavaScript blokkeren. Zonder deze bestanden ziet Googlebot een kale, kapotte pagina in plaats van wat je bezoeker ziet. Dat is geen klein ongemak, dat is je site zonder stroom laten draaien en verwachten dat alles blijft werken.
- Disallow combineren met noindex op dezelfde URL. Dit lijkt logisch (dubbel beveiligd, toch?) maar werkt averechts. Blokkeer je een pagina met disallow, dan komt de crawler nooit bij de noindex-tag, want die staat in de broncode die hij niet mag lezen. Martin Splitt van Google waarschuwt hier expliciet voor: gebruik nooit disallow en noindex samen op dezelfde pagina, zo meldt Search Engine Journal. Wil je een pagina echt uit de resultaten, gebruik dan alleen noindex en laat de crawler toe.
- Case-sensitivity en trailing slash-fouten. Een hoofdletter verschil of een vergeten slash maakt een regel onbruikbaar of juist te breed. Test elke regel tegen echte URL’s, niet tegen wat je dénkt dat de URL is.
- Een algehele disallow die blijft staan na een migratie. Veel ontwikkelomgevingen starten met
Disallow: /om indexering tijdens de bouw te voorkomen. Vergeet je die regel te verwijderen bij livegang, dan sluit je je hele site af voor elke crawler.
Ontdek je zo’n fout, dan is het herstel meestal snel maar vereist het geduld. Pas de regel aan, open de robots.txt-rapportage in Search Console en vraag daar een nieuwe check aan. Google cachet robots.txt doorgaans 24 uur, dus een aanpassing werkt niet altijd direct door. Vraag daarna een recrawl aan voor de belangrijkste pagina’s die geraakt zijn. Herstel is geen kwestie van wachten, het is een kwestie van de juiste knoppen indrukken in de juiste volgorde.
Meer over wat er precies breekt als rendering mislukt, lees je in onze gids over JavaScript SEO.
Hoe je robots.txt test en valideert voor je live gaat
Niemand zou robots.txt live zetten zonder te testen, maar het gebeurt voortdurend. Een foute regel komt er vaak pas uit als het verkeer al drie weken daalt.
Begin lokaal. Met curl jouwdomein.nl/robots.txt zie je direct wat een crawler daadwerkelijk ontvangt, inclusief eventuele server-fouten die de inhoud vervormen. Open-source robots-parserbibliotheken (de meeste programmeertalen hebben er een) laten je specifieke URL’s tegen je regels testen voordat je ze publiceert, zodat je weet of een pad echt geblokkeerd wordt of niet.
Eenmaal live is het robots.txt-rapport in Search Console je eerste checkpunt. Daar zie je of Google het bestand correct heeft opgehaald, wanneer dat voor het laatst gebeurde, en of er parse-fouten zijn gevonden. Vraag na een belangrijke wijziging altijd een nieuwe crawl aan in plaats van te wachten tot Google er zelf langskomt.
Controleer ook de basis eromheen:
- De HTTP-statuscode van robots.txt zelf moet 200 zijn: een 404 of 5xx kan crawlers laten concluderen dat alles geblokkeerd is.
- Redirects op het robots.txt-bestand zelf zijn af te raden: volgens RFC 9309 volgen crawlers een beperkt aantal redirect-stappen voordat ze het bestand als onbereikbaar beschouwen.
- Cache-gedrag: reken op tot 24 uur vertraging voordat een wijziging overal doorwerkt.
- Vergelijk crawlgedrag voor en na de wijziging via je serverlogs, dat is het enige bewijs dat je regel het gewenste effect heeft.
Die laatste stap wordt het vaakst overgeslagen, en is tegelijk de enige manier om zeker te weten of een aanpassing werkt zoals bedoeld. Zonder logfile-controle verander je een regel en hoop je het beste, en hopen is geen SEO-strategie.
Implementatie: uploaden, hosting en CMS-specifieke aandachtspunten
Robots.txt moet in de root van je domein staan, nergens anders. Een bestand op jouwdomein.nl/pagina/robots.txt wordt simpelweg genegeerd.
- Plaats het bestand op het juiste niveau. Elke combinatie van protocol, host en poort heeft zijn eigen robots.txt nodig.
https://jouwdomein.nlenhttps://shop.jouwdomein.nlzijn voor crawlers twee verschillende hosts, en hebben dus allebei een eigen bestand nodig als je per subdomein andere regels wilt. - Gebruik UTF-8 encoding bij het opslaan. Veel tekstverwerkers slaan standaard een ander formaat op, wat tot onverwachte parse-problemen leidt.
- Controleer bestandspermissies na upload. Het bestand moet publiek leesbaar zijn (meestal rechten zoals 644), anders krijgt de crawler een foutmelding in plaats van je regels.
- Gebruik je CMS-instellingen als dat kan. WordPress-sites genereren vaak automatisch een robots.txt via SEO-plugins; controleer die instellingen in plaats van blind een los bestand te uploaden, want anders overschrijft het één het ander.
- Heb je geen root-toegang? Sommige hostingpanelen of subdomein-structuren bieden geen directe toegang tot de root. Vraag dan bij je hostingpartij naar een optie om het bestand via een redirect of CDN-regel te serveren, want zonder dat bestand op de juiste plek heb je geen enkele controle over crawling.
Praktische naslag over het indienen en controleren van je bestand bij zoekmachines vind je bij TyTe Hosting, al blijft de Search Console-rapportage je eerste en belangrijkste bron.
Gevorderde scenario’s: grote sites, dynamische robots.txt en staging
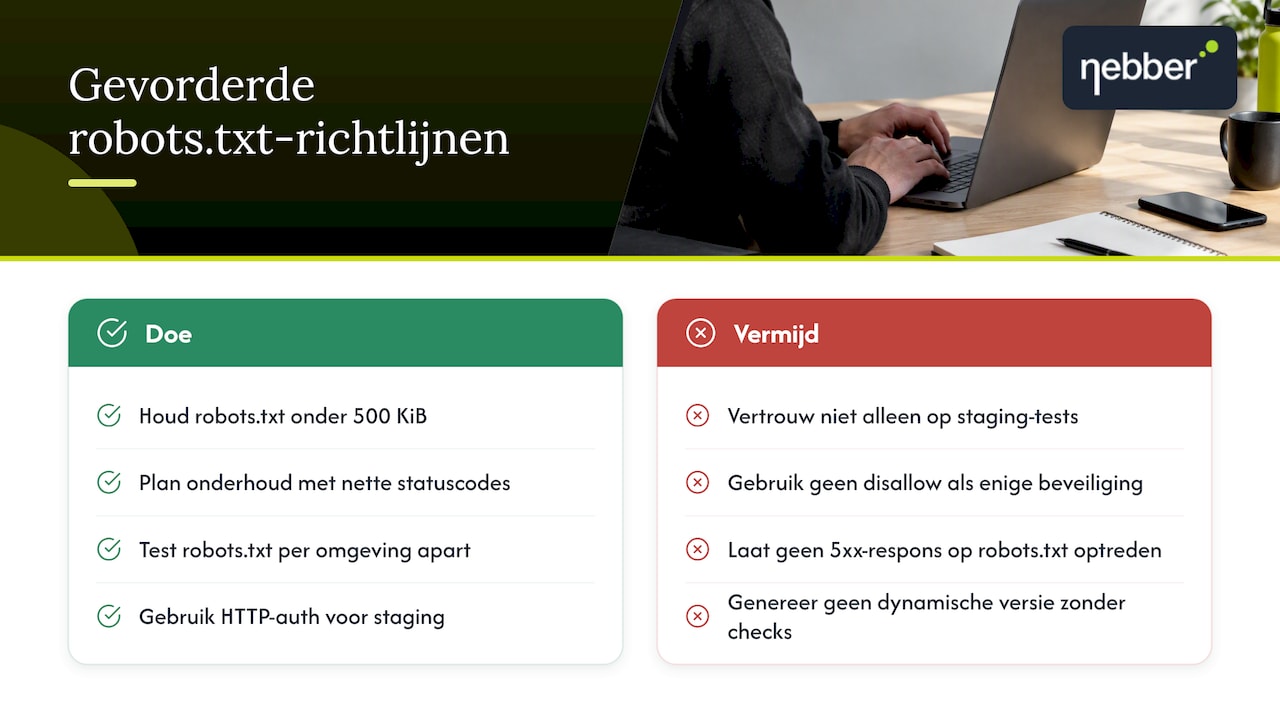
Grotere sites lopen tegen andere problemen aan dan een standaard bedrijfssite. Een robots.txt-bestand boven de 500 KiB kan door crawlers deels buiten beschouwing worden gelaten, zo blijkt uit de specificatie van Google. Heb je zo veel regels nodig dat je die grens nadert, dan is dat een signaal dat je URL-structuur te rommelig is, niet dat je bestand groter moet.
Redirects en serverfouten hebben directe gevolgen voor hoe crawlers je robots.txt behandelen. Geeft je server tijdens onderhoud een 5xx-foutcode terug op het robots.txt-verzoek, dan mogen crawlers volgens RFC 9309 aannemen dat alles geblokkeerd is, ook al was dat niet je bedoeling. Plan onderhoudsvensters dus met een bewuste strategie, bijvoorbeeld door tijdens korte onderhoudsperiodes een nette statuscode te blijven serveren in plaats van een onbedoelde algehele blokkade te riskeren.
Dynamisch gegenereerde robots.txt-bestanden (waarbij de inhoud per omgeving verschilt, zoals test versus productie) zijn krachtig maar riskant. Een script dat de verkeerde variabele leest, kan je complete productieomgeving per ongeluk blokkeren terwijl iedereen denkt dat alleen de testomgeving is afgeschermd. Test dit soort opzet altijd met een losse check per omgeving, nooit met een enkele “het werkte op staging” aanname.
Over staging gesproken: een Disallow: / op je testomgeving is geen beveiliging, het is een bordje “niet kijken” op een deur die toch openstaat. Robots.txt is openbaar leesbaar, dus iedereen die het bestand opvraagt ziet precies welke paden je wilt verbergen. Wachtwoordbeveiliging via HTTP-authenticatie is de enige manier die staging echt afschermt, zoals Search Engine Land ook benadrukt.
Pro-tip: zet nooit alleen disallow op een stagingomgeving; combineer het hooguit met echte toegangscontrole, anders ligt je onafgemaakte site gewoon voor het oprapen.
Praktijkchecklist: wat we in audits het vaakst terugzien
Na 19 jaar audits zien we dezelfde patronen telkens terugkomen, bij kleine webshops en bij grote internationale sites. Robots.txt is zelden het probleem op zichzelf, het is meestal het symptoom van een site die zonder duidelijk plan is gegroeid.
Een checklist die we zelf aanhouden bij elke technische scan:
- Staat er geen
Disallow: /die nog van de ontwikkelomgeving stamt. - Zijn CSS- en JavaScript-mappen expliciet toegankelijk, niet alleen “waarschijnlijk niet geblokkeerd”.
- Komt er geen disallow en noindex samen voor op dezelfde URL.
- Verwijst de sitemap-regel naar de actuele, actieve sitemap, niet naar een oude versie.
- Zijn parameter-URL’s en interne zoekresultaten bewust uitgesloten, niet per ongeluk meegenomen.
- Is er na elke grote sitewijziging een nieuwe check gedaan in het robots.txt-rapport.
Quick wins zijn meestal de trailing slash-fouten en de vergeten ontwikkelregels, die kosten vijf minuten om te vinden en op te lossen. Blokkerende issues, zoals een complete sectie die per ongeluk is afgesloten, vragen om onmiddellijke actie: wortel eruit, altijd, voordat je verder kijkt naar iets anders.
Wanneer schakel je hulp in? Zodra je twijfelt of een regel precies doet wat je bedoelt, of wanneer een sitewijziging meerdere ploegen (ontwikkelaars, content, hosting) raakt. Een technische audit vangt dit soort risico’s voordat ze rankings kosten, in plaats van erna op te ruimen.
Waarom ik robots.txt altijd als verkeersregelaar zie
Robots.txt is geen verwijderknop. Het is een verkeersregelaar die bepaalt wie welke straat in mag, niet wie er mag blijven wonen. Gebruik het zo, en het beschermt je crawl-budget zonder dat het ooit je zichtbaarheid aantast.
De momenten waarop het misgaat zijn vrijwel altijd dezelfde: een migratie, een sitewijziging, een nieuwe omgeving die live gaat zonder laatste check. Maak van de robots.txt-controle daarom een vast punt bij elke grote wijziging, net zo standaard als je checkt of de site nog laadt.
En als je twijfelt of iets werkt zoals je denkt: kijk niet naar aannames, kijk naar je logbestanden en naar het Search Console-rapport. Dat zijn de enige twee plekken die je echt vertellen wat er gebeurt, de rest is giswerk.
— Ramon
Hulp nodig bij je robots.txt en technische SEO
Een robots.txt-fout vinden we vrijwel altijd terug bij een technische scan, meestal binnen de eerste paar uur van het onderzoek. Twijfel je of jouw bestand crawl-budget weglekt of juist de verkeerde pagina’s blokkeert, dan is een gerichte check sneller dan zelf uren zoeken in documentatie.
Een technische audit brengt niet alleen je robots.txt in kaart, maar ook de rendering, interne links en crawlpatronen eromheen, met concrete herstelstappen in plaats van een lijst waarschuwingen. Onze aanpak is gericht op directe samenwerking met ontwikkelaars en contentteams zodat verbeteringen snel worden doorgevoerd.
Wil je weten wat zo’n technische audit oplevert voor jouw site, bekijk dan ons aanbod op Nebber en vraag een scan aan.
Veelgestelde vragen
Is robots.txt nog steeds relevant voor SEO in 2026?
Ja, robots.txt blijft de eerste plek waar crawlers kijken voordat ze je site bezoeken, en dat verandert niet. Het Robots Exclusion Protocol is in 2022 zelfs geformaliseerd als internationale standaard, wat het belang alleen maar bevestigt.
Wat is een robots-tag in SEO?
Een robots-tag (of meta robots-tag) is een instructie in de HTML-broncode van een pagina die aangeeft of die pagina geïndexeerd mag worden, los van de robots.txt op serverniveau. Waar robots.txt crawling blokkeert voordat de pagina bezocht wordt, werkt de robots-tag juist na het bezoek en stuurt indexering.
Is robots.txt afdwingbaar?
Nee, robots.txt is een vrijwillige afspraak: betrouwbare crawlers zoals Googlebot volgen de regels, maar niets dwingt een bot om zich erin te houden. Voor echte afscherming, zoals bij een stagingomgeving, is wachtwoordbeveiliging nodig in plaats van alleen een disallow-regel, zoals ook blijkt uit praktijkadvies van Search Engine Land.
Hoe los ik de foutmelding “geblokkeerd door robots.txt” op?
Zoek eerst de exacte regel op die de URL blokkeert via het robots.txt-rapport in Search Console en controleer of die blokkade bewust is. Is het een vergissing, pas de regel aan, vraag een nieuwe crawl aan en houd rekening met de gebruikelijke cache-periode van ongeveer 24 uur voordat de wijziging overal doorwerkt.
Moet ik disallow gebruiken om een pagina uit Google te verwijderen?
Nee, gebruik daarvoor een noindex-instructie en laat de crawler de pagina juist bezoeken. Martin Splitt van Google waarschuwt expliciet dat disallow en noindex samen niet werken, omdat de crawler de noindex-instructie nooit leest als de pagina al geblokkeerd is, zo meldt Search Engine Journal.
Bronnen
- How Google interprets the robots.txt specification | Google Crawling Infrastructure
- RFC 9309 — Robots Exclusion Protocol
- Robots.txt: SEO landmine or secret weapon?
- Google On Robots.txt: When To Use Noindex vs. Disallow