
Optimaliseer je crawl budget alleen als je site groot is of vaak verandert. Bij een brochurewebsite van twintig pagina’s is dit weggegooide energie. Crawlbudget is de optelsom van crawl-capaciteit (wat je server aankan) en crawl-vraag (wat Google wil ophalen). Twijfel je? Exporteer je Crawl stats-rapport en je serverlogs en zoek naar 5xx-fouten, 429’s en verkeerspieken. Dat is stap één, altijd.
Kort samengevat:
- Alleen grote of snel veranderende websites hoeven het crawlbudget te optimaliseren, omdat kleine sites met weinig frequentie geen problemen hebben.
- Het meten van crawlactiviteit verloopt via combinatie van Search Console-rapporten en serverlogs, met focus op lange termijn data van minimaal twee weken.
- Het herstellen van serverfouten en het beperken van requests voor irrelevante URL’s besparen crawlcapaciteit en verhogen de efficiëntie.
- Een goede sitemap en correct gebruik van robots.txt en noindex voorkomen onnodige crawl- en indexatiekosten, zonder dat Google de pagina’s volledig blokkeert.
- Structurele veranderingen, zoals het korter maken van redirectketens en oplossen van soft-404’s, leveren langdurig rendement op en verlagen onnodige crawlverspilling.
Inhoudsopgave
- Wat is crawl budget optimaliseren precies?
- Wanneer is crawl budget relevant voor jouw site?
- Hoe meet je crawlactiviteit concreet?
- Servergezondheid en caching: waar je écht ruimte wint
- Sitemaps, robots.txt en noindex: wat wel en niet werkt
- URL-inventaris, redirects en canonicalisatie opschonen
- In welke volgorde voer je de audit uit?
- Hoe pak ik een crawl-audit in de praktijk aan?
- Wanneer is dit níet de beste inzet van je tijd?
- Technische audit en interim SEO door Nebber
- Bronnen
- Veelgestelde vragen
Wat is crawl budget optimaliseren precies?
Crawl budget bestaat uit twee onderdelen die je vaak door elkaar ziet lopen. Crawl-capaciteit is de hoeveelheid water die je leidingen aankunnen: hoeveel verzoeken je server verwerkt zonder dicht te slaan. Crawl-vraag is de dorst van Google: hoeveel de zoekmachine wíl ophalen, gebaseerd op populariteit en hoe vaak content wijzigt. Google zelf omschrijft dit als een combinatie van hostload en crawl-vraag, niet als een vast getal dat je in een dashboard aflezen kunt.
De grootste misvatting: mensen denken dat robots.txt een URL onzichtbaar maakt in de zoekresultaten. Dat is onjuist. Robots.txt stopt het crawlen, niet noodzakelijk de indexering van een URL die elders gelinkt wordt.
Budget lekt weg via plekken die je zelden checkt:
- Parameter-URL’s van filters en sorteeropties
- Faceted navigatie die duizenden variaties van dezelfde pagina genereert
- JavaScript- en XHR-verzoeken die render-kosten met zich meebrengen
- Alternatieve URL-versies (met en zonder trailing slash, met en zonder www)
Elk van die punten kost crawl-capaciteit zonder dat er businesswaarde tegenover staat.
Wanneer is crawl budget relevant voor jouw site?
Grote sites en sites die vaak veranderen. Kleine brochurewebsites niet. Zo simpel is de vuistregel, en zo houdt Google het ook aan: crawlbudget is vooral een thema voor zeer grote of snel veranderende sites, niet voor een lokale ondernemer met dertig pagina’s.
Kijk naar deze signalen om te bepalen of jij in die categorie valt:
- Je publiceert of wijzigt honderden URL’s per week (webshops, vacaturesites, nieuwsplatforms)
- Nieuwe productpagina’s staan na een week nog niet geïndexeerd
- Je Crawl stats-rapport toont regelmatig pieken in 5xx- of 429-responses
Pro-tip: *Check niet alleen het aantal crawls, maar ook de verdeling.
Zie je herhaalde serverfouten gecombineerd met vertraagde indexatie van commercieel belangrijke pagina’s? Dan handel je nu. Zie je een stabiel, klein sitemapbestand zonder foutmeldingen? Dan is basisbeheer, twee keer per jaar een check, voldoende.
Hoe meet je crawlactiviteit concreet?
Meten gaat met twee bronnen tegelijk, niet met losse steekproeven. Google geeft zelf geen enkelvoudig “crawlbudget-cijfer” terug; je moet het combineren uit Crawl stats, Page Indexing en URL-inspectie in Search Console met je eigen serverlogs.
Zo bouw je het meetproces op:
- Open het Crawl stats-rapport in Google Search Console en bekijk hostnaamstatus, responstijd en de verdeling van statuscodes.
- Exporteer je serverlogs over minimaal twee weken en filter op de Googlebot user-agent, niet op alle bots die zich als Googlebot voordoen.
- Koppel logregels aan URL-patronen: welk deel van het verkeer gaat naar productpagina’s, welk deel naar filters of oude campagne-URL’s?
- Gebruik URL-inspectie voor steekproeven op belangrijke pagina’s: wanneer is er laatst gecrawld, en wat was de uitkomst?
- Zoek specifiek naar redirectketens, soft-404’s die een 200 teruggeven, en trage responstijden boven de seconde.
Een subdomein telt trouwens als een eigen site met een eigen budget. Meerdere crawlers kunnen capaciteit delen en elkaar in de weg zitten, dus check hostnaam-niveau apart als je met subdomeinen werkt.
Pro-tip: Meet in weken, niet in uren. Eén dag met een piek in 429-responses zegt niets over een structureel probleem; twee weken aan data wel.
Servergezondheid en caching: waar je écht ruimte wint
Herstel eerst je server, dan pas de rest. Dat is de volgorde. Een site die veel 5xx-fouten, time-outs of 429’s teruggeeft, wordt door Google zelf teruggeschroefd in crawlsnelheid: de zoekmachine verlaagt de crawl-rate automatisch als je server signalen van overbelasting afgeeft. Je verliest dus capaciteit precies op het moment dat je die het hardst nodig hebt.
Drie technische ingrepen die dat water echt afsluiten in plaats van dweilen:
- Implementeer HTTP-caching met ETag en Last-Modified, zodat Google met een If-None-Match-verzoek een 304 Not Modified terugkrijgt in plaats van de hele pagina opnieuw op te halen.
- Schaal serverresources op piekmomenten, of verplaats zware processen naar achtergrondtaken zodat Googlebot niet in de wachtrij staat.
- Dedupliceer gedeelde CSS- en JavaScript-bestanden, zodat Google niet honderd keer hetzelfde script ophaalt onder een net iets andere URL.
Servergezondheid is de randvoorwaarde onder alles: de crawler wil zoveel mogelijk ophalen zonder je infrastructuur te verzwaren, en kijkt daarvoor naar hoststatus en responsdata uit je logs. Vergeet renderkosten niet: CSS, JavaScript en XHR-verzoeken tellen mee in wat Google moet ophalen, dus blokkeer geen resources die nodig zijn om de pagina goed te renderen.
Sitemaps, robots.txt en noindex: wat wel en niet werkt
Een sitemap is een uitnodiging, geen bevel. Zet er alleen URL’s in die je écht wilt laten crawlen en indexeren, gebruik lastmod alleen bij content die daadwerkelijk gewijzigd is, en houd het bestand schoon. Een sitemap vol met verlopen URL’s is als een boodschappenlijstje met producten die al uitverkocht zijn: Google gaat toch kijken en komt met lege handen terug.
Robots.txt is bedoeld om crawltijd te besparen, niet om iets uit de zoekresultaten te houden. Dat is een cruciaal onderscheid: robots.txt voorkomt crawling, maar garandeert niet dat een URL niet in Search verschijnt als die elders gelinkt wordt. Wil je dat een pagina echt niet verschijnt? Gebruik dan noindex, en besef dat Google de pagina eerst moet kunnen crawlen om die instructie te lezen.
Praktische regels die veel misgaan:
- Gebruik robots.txt voor structurele categorieën zoals interne zoekresultaten of admin-paden, niet voor losse pagina’s.
- Gebruik noindex voor content die inhoudelijk niet in Search moet staan, zoals testpagina’s.
- Combineer noindex met echte toegangsbeveiliging (login, wachtwoord) voor werkelijk gevoelige content. Noindex alleen is geen slot op de deur.
URL-inventaris, redirects en canonicalisatie opschonen
Elke onnodige stap in een redirectketen is een extra emmer water die je zelf laat weglopen voordat Googlebot bij de bron komt. Verkort ketens tot maximaal één stap, en zorg dat interne links direct naar de finale URL wijzen in plaats van via drie tussenstops.
Canonical tags helpen, maar zijn geen volledige oplossing. Google kan alternatieve URL’s nog steeds crawlen, ook als je netjes een canonical hebt gezet, omdat canonicals een signaal zijn en geen commando. Los daarom het probleem bij de bron op: een generator die duizenden faceted-navigatie-URL’s spuugt, verhelp je in de code, niet met honderd canonical-tags erbovenop.
Structurele fixes zijn duurzamer dan telkens sleutelen aan robots.txt om budget te verschuiven. Wat je concreet moet doen:
- Identificeer soft-404’s: pagina’s die inhoudelijk “niet gevonden” zeggen maar een 200-statuscode teruggeven.
- Zoek interne links die naar dode of verwijderde URL’s wijzen en herstel of verwijder ze.
- Classificeer statuscodes in bulk. Niet elke 404 is verspilling; de echte schade zit in interne links naar dode URL’s en eindeloze redirectketens, niet in het aantal 404’s op zich.
Voor de technische basis onder deze fixes is een logfile-analyse voor SEO je startpunt, en het artikel over de canonical tag legt uit waar linkwaarde precies weglekt.
In welke volgorde voer je de audit uit?
Volgorde bepaalt of je tijd verspilt of resultaat boekt. Dit is de route die werkt, gebaseerd op Google’s eigen aanbevolen aanpak voor crawlfouten:
- Bepaal relevantie: is jouw site groot of snel veranderend genoeg om dit te rechtvaardigen?
- Exporteer Crawl stats en serverlogs over minimaal twee weken.
- Herstel serverfouten: 5xx, time-outs en 429’s krijgen voorrang boven alles.
- Sluit structurele bronnen van verspilling uit: parameters, faceted navigatie, oude campagne-URL’s.
- Maak sitemaps en interne links schoon, verwijder verlopen of dode URL’s.
- Test robots.txt, canonicals en rendering opnieuw.
- Meet gedurende twee tot acht weken opnieuw en vergelijk met je startpunt.
| Meetpunt | Voor de fix | Waar je op let na de fix |
|---|---|---|
| Crawl stats hostnaamstatus | Piekwaarden in 5xx/429 | Stabiele responstijd, minder foutcodes |
| Indexatie van target-URL’s | Vertraging van dagen tot weken | Snellere opname na publicatie |
| Verdeling van crawls | Groot deel naar filter/parameter-URL’s | Groter deel naar commercieel relevante pagina’s |
Reken niet op resultaat binnen een week. Twee tot acht weken is realistisch voordat je de verschuiving in de cijfers ziet.
Hoe pak ik een crawl-audit in de praktijk aan?
Ik begin altijd met de logs, nooit met aannames. Een dashboard vertelt je wat Google zégt te doen; de logfile vertelt je wat er écht gebeurt op je server. Die twee komen zelden helemaal overeen.
Mijn volgorde: eerst logfile-export, dan koppelen aan de data uit Search Console, en pas daarna prioriteren op zakelijk gewicht. Niet elke URL is evenveel waard. Een productpagina die omzet maakt, weegt zwaarder dan duizend filtercombinaties die niemand ooit deelt of bezoekt.
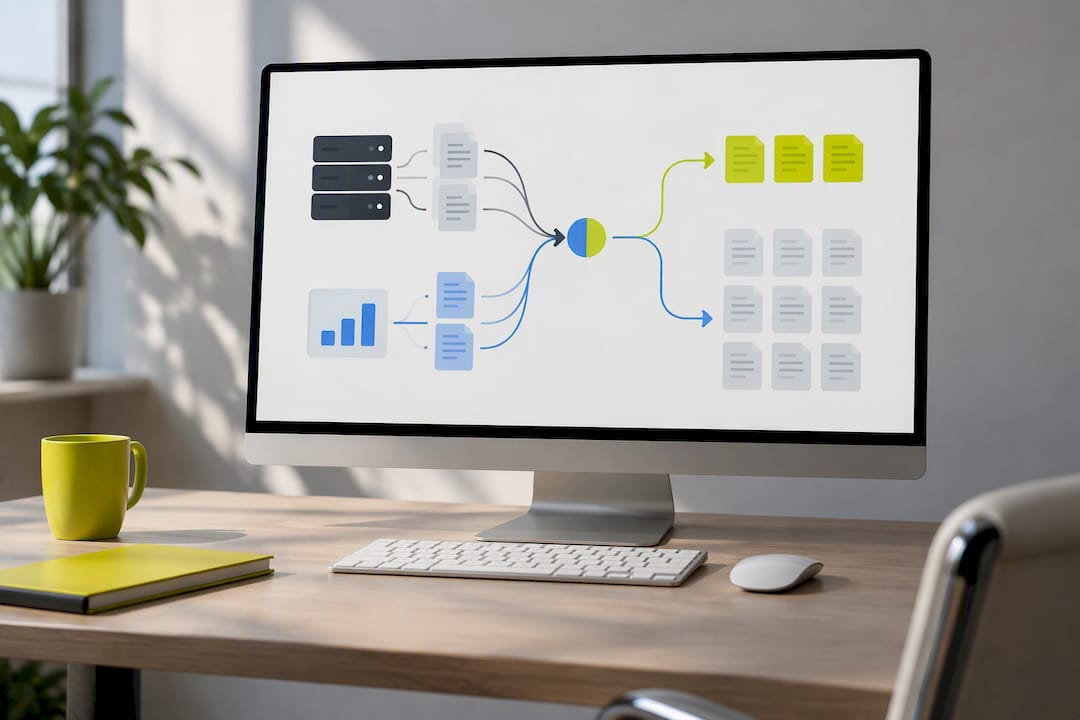
Typisch beeld bij een audit: een aanzienlijk deel van de crawls gaat naar filter-URL’s die geen enkele zakelijke waarde toevoegen. De remedie is dan niet “meer content maken”, maar juist het tegenovergestelde: bronnen uitsluiten en interne links opschonen zodat Googlebot zijn tijd besteedt aan wat telt.
Wat ik concreet controleer bij elke audit:
- Hoststatus en foutratio’s per sectie van de site
- Verdeling van crawls tussen commercieel belangrijke en irrelevante URL’s
- Snelheid van indexatie na publicatie van nieuwe pagina’s
Pro-tip: Vraag altijd om minimaal veertien dagen aan logdata voordat je conclusies trekt. Eén slechte dag vertekent het hele beeld.
Wanneer is dit níet de beste inzet van je tijd?
Skip dit als je een kleine brochuresite runt zonder frequente updates. Twintig pagina’s die twee keer per jaar wijzigen hebben geen crawlbudget-probleem. Punt.
Rendement zit bij productpagina’s, feeds en veelbezochte landingspagina’s. Daar telt elke dag vertraging in indexatie mee in gemiste omzet. Bij een webshop met duizenden SKU’s of een site met dagelijkse contentupdates is dit geen technisch detail meer, maar een omzetvraagstuk.
Een specialist inhuren wordt pas rendabel zodra je logfile-analyse en Search Console-data structurele patronen laten zien die je zelf niet oplost. Denk aan blijvende 429’s, indexatievertraging van weken, of duizenden onnodige parameter-URL’s. Wortel eruit, altijd, maar dan moet er wel een wortel zijn om uit te trekken.
— Ramon
Technische audit en interim SEO door Nebber
Dit is een alternatief voor bureaus met lange trajecten en vage rapportages: directe samenwerking met webdevelopers, gericht op meetbare resultaten in weken, niet in kwartalen.
Een technische audit omvat logfile-analyse, een prioriteitenlijst op basis van zakelijk gewicht, en concreet implementatieadvies dat developers meteen kunnen oppakken. Geen dertig pagina’s aan theorie, maar een lijst met wat eerst moet gebeuren en waarom. Dit is vooral waardevol voor sites met veel URL’s, terugkerende indexatieproblemen of een crawlbudget dat structureel weglekt naar de verkeerde plekken.
Twijfel je of jouw situatie dit rechtvaardigt? Bekijk de scope en aanpak op de pagina van Nebber en vraag een korte technische scan aan om te zien waar je crawlbudget precies weglekt voordat je in een groter traject stapt.
Veelgestelde vragen
Wat is het verschil tussen crawl-capaciteit en crawl-vraag?
Crawl-capaciteit is hoeveel verzoeken je server aankan zonder problemen. Crawl-vraag is hoeveel Google daadwerkelijk wíl ophalen, gebaseerd op populariteit en updatefrequentie. Beide componenten samen vormen wat vaak losjes “crawlbudget” wordt genoemd, zoals Google zelf beschrijft.
Verhoogt een nieuwe sitemap automatisch mijn crawlbudget?
Nee. Een sitemap is een uitnodiging, geen commando dat Google verplicht meer te crawlen. Zorg dat de sitemap alleen indexeerbare URL’s bevat en actueel is; dat helpt bij efficiëntie, niet bij het “verhogen” van een budget dat niet als vast getal bestaat.
Blokkeert robots.txt een pagina volledig uit Google?
Niet gegarandeerd. Robots.txt voorkomt dat Googlebot een pagina crawlt, maar de URL kan nog steeds in zoekresultaten verschijnen als die elders gelinkt wordt. Gebruik noindex als je zeker wilt zijn dat een pagina niet in Search verschijnt.
Hoe snel zie ik resultaat na crawl budget optimaliseren?
Reken op twee tot acht weken voordat verschuivingen in Crawl stats en indexatiesnelheid zichtbaar worden. Serverfixes zoals het herstellen van 5xx-fouten werken vaak sneller dan structurele opschoning van URL-inventaris.
Kan Nebber een crawl-audit voor mijn site uitvoeren?
Ja, Ramon van Nebber voert technische audits uit die logfile-analyse, Search Console-data en prioritering op zakelijk gewicht combineren. Bekijk de aanpak en mogelijkheden op de website van Nebber voor een intake of korte scan.